这一周总榜前十里只有两组互换,看起来风平浪静,但第一名终于被拉出来重新考了一次:Gemini 4 Argon 一周里多收了 5,183 张票,Elo 掉了 6.6 分,对第二名的领先优势从 16.1 分缩到 9.6 分。下面先看一张另一套口径的能力指数榜,再回到 2026 年 10 月 21 日到 27 日的 LMArena 读数。
1. 能力指数 TOP30
开篇先看一张不同口径的榜单。下面这张图用的是 Artificial Analysis 的 Intelligence Index:把十来项评测合成一个 0–100 的分数,衡量的是“综合能力水平”,和后面几节 LMArena 的 Elo 不是一回事,两套分数不能互换,也不能放在一句话里比较大小。图后是四条对照观察,读完再往下看社区盲测的总榜。
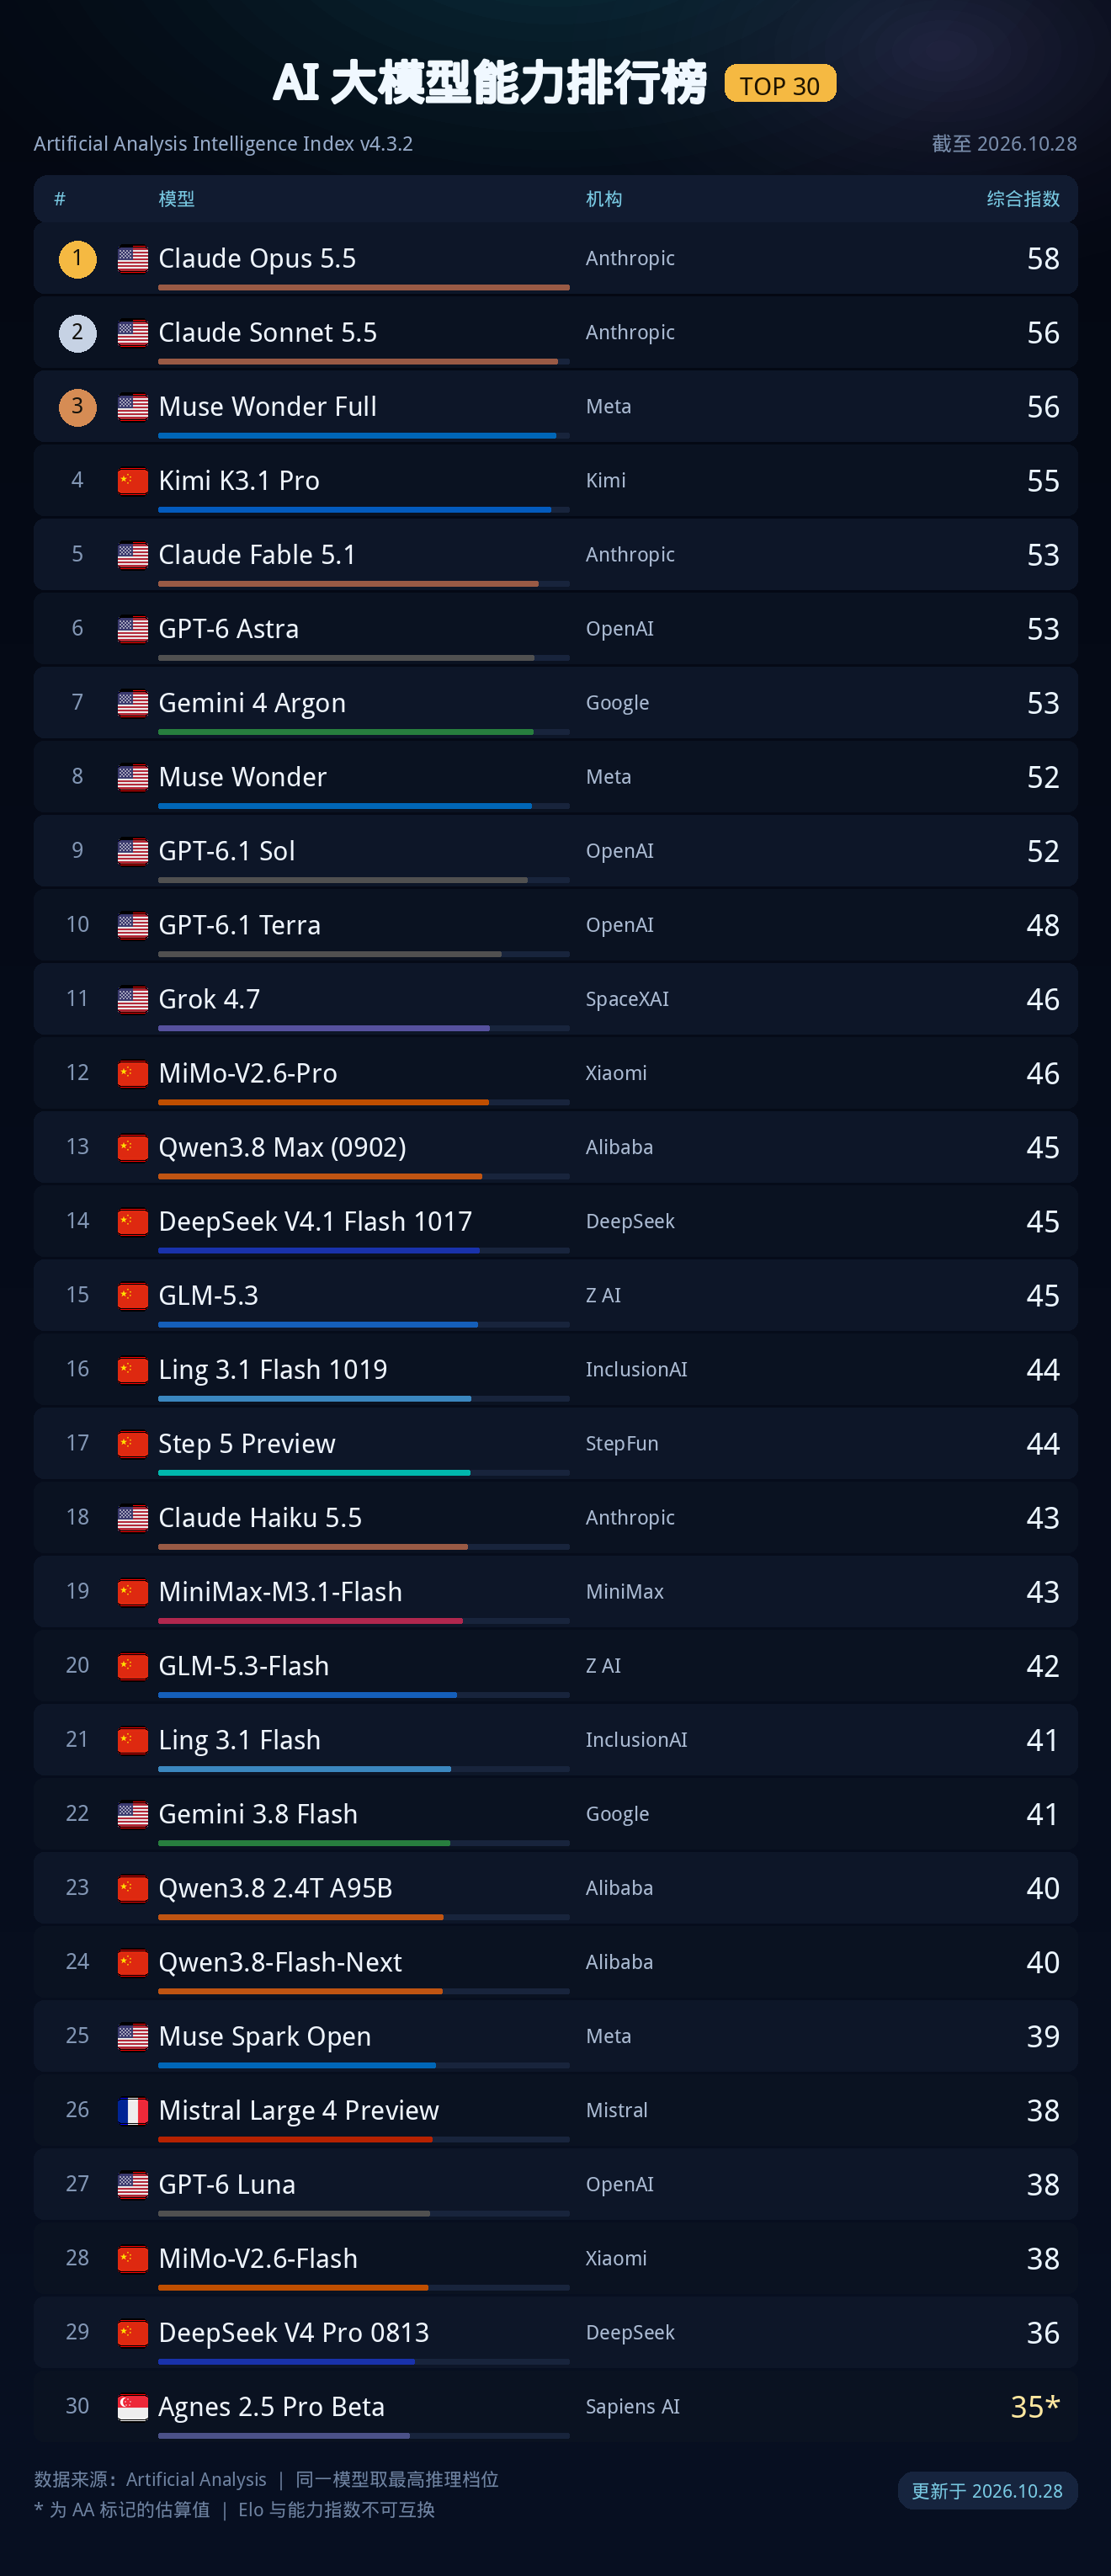
四条对照观察:
头部构成:前五里 Anthropic 占三席(Claude Opus 5.5 57.62、Claude Sonnet 5.5 56.00、Claude Fable 5.1 53.35),Meta 的 Muse Wonder Full 以 55.80 排在第三,Kimi K3.1 Pro 以 55.09 排第四。和 LMArena 前五(三席 Anthropic、一席 Meta、一席 Google)相比,这里挤进来的是月之暗面,被挤出去的是 Google。
中国厂商密度:前 30 名里中国厂商 14 席,接近一半,比 LMArena 前 50 的 16 席(32%)更密。两家榜的采样和加权方式不同,但都指向同一个方向。
开源最高位:这份榜不带许可字段,开源判断要拿 LMArena 的 license 交叉核对——MiMo-V2.6-Pro(第 12)和 GLM-5.3(第 15)都是 MIT,是开放权重里排得最高的两个。
梯队落差:前 9 名都在 50 分以上,第 9 名(51.83)到第 10 名(48.11)之间有 3.72 分,是前 30 里最大的一道断层;榜尾第 30 名是 35.24 分。也就是说第一梯队和"够用"之间,中间几乎没有过渡带。
图上有两个前提要交代:同一个模型的不同推理档位只取最高分,所以分数不代表默认调用的表现;带 * 的是 AA 自己标注的估算值(本期是第 30 名的 Agnes 2.5 Pro Beta)。图上的"截至"是 10 月 28 日,比本文的数据窗口多一天。
2. 本期速览
- 分数最高:Gemini 4 Argon (High),1,525.7 分。它这周票数从 4,900 涨到 10,083,是本期唯一被大量新对局检验的头部模型。
- 投票最多:Gemini 3.1 Pro Preview 的 130,819 票(第 19 名),前 20 名合计 850,997 票,Anthropic 一家占了其中九席。
- 厂商分布:前 50 名里 Anthropic 14 席、Google 10 席,Meta 与 OpenAI 各 5 席,中国厂商合计 16 席。
| 排名 | 模型 | 厂商 | Elo | 周变化 | 投票数 | 上期 |
|---|---|---|---|---|---|---|
| 1 | Gemini 4 Argon (High) | 1,525.7 | -6.6 | 10,083 | #1 | |
| 2 | Claude Opus 5.5 (High) | Anthropic | 1,516.2 | 持平 | 10,322 | #2 |
| 3 | Claude Fable 5.1 (Max) | Anthropic | 1,512.5 | +0.6 | 16,343 | #3 |
| 4 | Claude Opus 5 (Max) | Anthropic | 1,508.3 | -0.3 | 34,526 | #4 |
| 5 | Claude Opus 5 (High) | Anthropic | 1,503.3 | +0.5 | 71,020 | #5 |
| 6 | Claude Opus 4.6 (High) | Anthropic | 1,501.5 | +0.2 | 83,454 | #7 |
| 7 | Muse Wonder (Max) | Meta | 1,500.5 | -1.2 | 6,001 | #6 |
| 8 | Gemini 3.8 Flash (High) | 1,498.3 | -0.6 | 43,997 | #8 | |
| 9 | Claude Opus 4.6 | Anthropic | 1,496.8 | -0.2 | 88,206 | #9 |
| 10 | Muse Spark 1.3 (Max) | Meta | 1,491.1 | +0.7 | 20,506 | #12 |
| 11 | MiMo-V2.6-Pro | Xiaomi | 1,491.1 | 持平 | 4,067 | #11 |
| 12 | Claude Fable 5 (High) | Anthropic | 1,490.9 | -0.3 | 44,253 | #10 |
| 13 | Claude Opus 4.7 (High) | Anthropic | 1,489.7 | 持平 | 65,140 | #13 |
| 14 | Gemini 3.7 Flash (High) | 1,489.5 | +1.0 | 30,501 | #14 | |
| 15 | Qwen3.8-Max | Alibaba | 1,483.6 | +0.4 | 30,500 | #15 |
| 16 | Claude Opus 4.7 | Anthropic | 1,483.0 | -0.1 | 66,183 | #16 |
| 17 | Muse Spark 1.2 (xHigh) | Meta | 1,481.9 | -0.5 | 10,470 | #17 |
| 18 | Gemini 3.5 Flash (High) | 1,481.9 | -0.1 | 48,504 | #18 | |
| 19 | Gemini 3.1 Pro Preview | 1,480.2 | +0.2 | 130,819 | #19 | |
| 20 | Gemini 3.6 Flash (High) | 1,479.6 | +0.1 | 36,102 | #20 |
3. 总榜变动
3.1 头部变化
本期唯一有分量的变化在第一名的分数上。Gemini 4 Argon (High) 从 1,532.3 掉到 1,525.7,跌了 6.6 分,同时票数从 4,900 涨到 10,083——一周里补进了 5,183 张票。前几期它的票数一直卡在 4,900 附近几乎不动,分数也就一直没被新对局检验过;这次补上一批,结果是被打回来 6.6 分,对第二名的领先从 16.1 分收到 9.6 分。
掉分不是集中在某一类任务上:编码 -6.7、指令遵循 -6.3、创意写作 -4.2、中文 -10.9,只有数学微涨 1.5。四个类别同向下跌,说明这是一批整体偏负的对局,而不是某个细分场景里出了意外。
其余头部位置只有交换,没有实质位移。Claude Opus 4.6 (High) 与 Muse Wonder (Max) 对调了第六和第七(+0.2 对 -1.2);Muse Spark 1.3 (Max) 从第 12 升到第 10,Claude Fable 5 (High) 从第 10 退到第 12,两者现在只差 0.2 分,属于互相贴着的换位。
3.2 中段换手
先把结论说清楚:这一期前 80 名里最大的名次位移只有 2 位,150 名里有 112 个模型的排名和上期完全一致。把下面几行当成"最大位移"来看,不要当成趋势。
上升
| 模型 | 名次变化 | Elo 变化 |
|---|---|---|
| Muse Spark 1.3 (Max) | #12 → #10 | +0.7 |
| Claude Opus 4.6 (High) | #7 → #6 | +0.2 |
| DeepSeek-V4.1-Flash-20260910 (Max) | #38 → #37 | +0.7 |
| GPT-5.6 Terra (xHigh) | #56 → #55 | +0.1 |
下降
| 模型 | 名次变化 | Elo 变化 |
|---|---|---|
| Claude Fable 5 (High) | #10 → #12 | -0.3 |
| Muse Wonder (Max) | #6 → #7 | -1.2 |
| Kimi K3 (Max) | #24 → #25 | -0.7 |
| MiMo-V2.5-Pro | #37 → #38 | 持平 |
前 20 名模型的 95% 置信区间半宽中位数是 4.6 分,也就是说上面这些 ±1 分上下的变动,全在区间之内。这周真正动的是分数而不是名次:Step 5 Preview 涨 1.7 分、Mistral Large 4 涨 1.1、Grok 4.6 (High) 涨 1.0;跌幅那边除了第一名,NVIDIA-Nemotron-3.5-Super-VL-120B 掉 1.3、Muse Wonder 掉 1.2、MiMo-V2.6-Flash 掉 1.0。名次没变,是因为相邻模型的分数同样在动。
3.3 新条目辨析
这一期总榜多了 1 个条目:Claude Haiku 5.5 (High),直接落在第 153 名,1,400.6 分、6,080 票。
它看起来像新模型,其实不是。OpenRouter 上 anthropic/claude-haiku-5.5 10 月 8 日就已经上架(1M 上下文,输入 $0.10、输出 $0.50 每百万 token),Artificial Analysis 的综合指数里也早就有它。所以这是"补测上榜",不是"本周发布",不该写进发布汇总。
两周前那种混乱倒是结束了。榜单在 10 月中旬把模型标识从内部 slug 改成了展示名,上期因此一次冒出 47 个"新条目";这周把名称归一之后,416 个条目里有 415 个能和上期对上,只剩这一个真补测。
4. 分项榜
4.1 编码与网页生成
| 类别 | 前三 | Elo | 投票数 |
|---|---|---|---|
| 编码 | Claude Opus 5.5 (High) | 1,545.0 | 2,314 |
| 编码 | Gemini 4 Argon (High) | 1,539.3 | 2,385 |
| 编码 | Claude Opus 4.6 | 1,534.4 | 24,319 |
| 网页生成 | Claude Opus 5.5 (Max) | 1,806.9 | 3,140 |
| 网页生成 | GPT-6 Astra (Max) | 1,774.3 | 6,579 |
| 网页生成 | Claude Sonnet 5.5 (xHigh) | 1,768.9 | 3,822 |
编码榜换了第一:Gemini 4 Argon 掉了 6.7 分,被 Claude Opus 5.5 (High) 以 5.6 分的差距反超。两者票数都在 2,300 上下,样本不算厚,但掉分方向和总榜一致。第五名 MiMo-V2.6-Pro(1,532.5,1,102 票)与第四名只差 0.07 分,是开源权重模型在编码榜上离前四最近的一次。
网页生成榜这周有两次快照(10 月 22 日、23 日),前六名的分数基本没动。变化在榜尾之外:Kimi K3.1 Pro (Max) 10 月 23 日第一次进榜就排到第 8,1,691.6 分、2,451 票,比自家的 Kimi K3 (Max) 高 36.7 分。
网页生成的整体分数比通用对话高 280 分以上,那是另一套独立拟合的结果,不能和总榜横向比较。
4.2 中文与数学
| 类别 | 前三 | Elo | 投票数 |
|---|---|---|---|
| 中文 | Gemini 4 Argon (High) | 1,600.2 | 737 |
| 中文 | Claude Fable 5.1 (Max) | 1,583.6 | 1,252 |
| 中文 | Claude Opus 5.5 (High) | 1,581.0 | 927 |
| 数学 | Gemini 4 Argon (High) | 1,537.8 | 577 |
| 数学 | Claude Opus 5 (Max) | 1,533.0 | 1,652 |
| 数学 | Claude Fable 5.1 (Max) | 1,532.3 | 796 |
中文榜的票数还是薄:第一只有 737 票,数学第一 577 票,和总榜动辄几万票不是一个量级。Gemini 4 Argon 在中文榜掉了 10.9 分,仍然领先第二名 16.6 分,这个差距不是一两批对局能翻过来的。数学榜前三名的分差只有 5.5 分,第二名和第三名差 0.7 分,这种距离在几百票的样本里基本等于并列。
两个榜的前三都没有国产模型,但这不代表国产模型中文或数学差——总榜前 50 里中国厂商有 16 席,它们的分数更多是靠综合表现站住的。
4.3 视觉与文生图
视觉理解这份榜本期没有新快照,最近一次还停在 10 月 19 日。前三仍是 Claude 系:Claude Fable 5 (High) 1,324.9(14,714 票)、Claude Opus 5.5 (High) 1,320.8(3,035 票)、Claude Opus 5 (High) 1,319.6(17,743 票)。
文生图这边终于更新了,上一次快照还是 10 月 7 日。新快照里票数普遍翻倍,名次结构没变:GPT-Image-2.5 Sunburst 1,427.4(40,323 票)、GPT-Image-2.5 Flare 1,401.3(39,218 票)、GPT-Image-2 (Medium) 1,381.3(103,385 票)。上一版靠十万票的积累守在前三,前两名的分差 26 分倒是这一期最稳的一段。第四和第五换了位:MAI-Image-2.6 升到第 4(1,328.6,34,596 票),Grok Imagine Image 2.0 掉到第 6(1,316.6,10,902 票)。
Sunburst 把写实、文字渲染、人像、卡通、3D、商业设计这些子项的第一全拿了,Flare 在每个子项都紧随其后。也就是说这个榜现在的悬念不在谁第一,而在第二名之后。
4.4 写作与指令遵循
创意写作第一是 Claude Opus 5.5 (High),1,534.2 分(2,453 票),领先 Gemini 4 Argon 11.1 分;指令遵循第一同样是它,1,538.8 分(3,593 票),领先 11.2 分,而两者的票数几乎一样(3,593 对 3,595)。
这两项是 Gemini 4 Argon 这周丢分最多的地方,和总榜的方向完全一致。有意思的是总榜第 2 名 Claude Opus 5.5 (High) 在这两个类别都是第一,但它在总榜上仍差第一名 9.6 分——通用偏好投票和单项任务的偏好,并不总是同一批人做出的同一个判断。
5. 开源侧热度
5.1 模型
| 模型 | 趋势分 | 喜欢 | 30 天下载 | 类型 | 创建 |
|---|---|---|---|---|---|
| deepseek-ai/DeepSeek-V4.1-Flash-1017 | 967 | 3,347 | 105,667 | 图文理解 | 10-17 |
| RecursiveSI/flint | 918 | 958 | 10,574 | 文本生成 | 10-21 |
| Nanbeige/Nanbeige4.3-33B | 648 | 655 | 4,785 | 文本生成 | 10-24 |
| XHToken/Spark-X2.6-4B | 607 | 777 | 6,191 | 文本生成 | 10-19 |
| black-forest-labs/flux-3-image-klein-comfy | 413 | 1,837 | 750,694 | 图像编辑 | 10-14 |
| Lightricks/LTX-2.5 | 404 | 9,559 | 2,163,739 | 图生视频 | 07-23 |
| MiniMaxAI/MiniMax-M3.1-Flash | 387 | 407 | 11,075 | 图文理解 | 10-17 |
| ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF | 365 | 386 | 1,105,751 | 文本生成 | 10-23 |
| Qwen/Qwen3.8-27B | 319 | 18,525 | 7,522,728 | 图文理解 | 08-05 |
| InternScience/Sage-A1.5 | 319 | 332 | 6,613 | 文本生成 | 10-15 |
DeepSeek-V4.1-Flash-1017 连续第二期排第一,但趋势分从上期同一时间的 1,766 掉到 967,几乎腰斩——热度还在最高位,只是峰值已经过去。第二名 RecursiveSI/flint 是 10 月 21 日才建的仓库,一周里拿到 918 分,是这周上升最快的新面孔。
真正值得看的是第八行:DeepSeek-V4.1-Flash 的 GGUF 量化版下载量 110.6 万,是原版(10.6 万)的十倍。榜单里的人在看 API,下载榜里的人在自己机器上跑。
LTX-2.5 的 216 万下载和 9,559 个喜欢、Qwen3.8-27B 的 752 万下载和 18,525 个喜欢,都是几个月积累出来的,不能当作本周热度。趋势分看的是近期相对增速,下载量是滚动 30 天口径,两列要分开读。
5.2 数据集与 Space
数据集榜第一是 nvidia/simready-assets(趋势 562,62.5 万下载),一个给物理仿真准备的资产集;第二是 10 月 19 日新建的 3D 素材集 scenario-labs/3d-collection(趋势 269)。后面依次是网络安全数据集(趋势 162)和 A 股 Level-2 逐笔委托数据(趋势 77,17.5 万下载)。另一个刚建两天的 CohereLabs 数据集记的是 Qwen 模型调查轨迹,趋势 63 但下载只有 638——榜单上排得靠前,不等于已经被用起来。
Space 榜前五全是图像或视频相关的封装:MiniMax-H3-Turbo 的 LoRA 工作流(趋势 290,478 喜欢)、Wan 模型的可视化界面(趋势 196,1,036 喜欢)、NVIDIA 的仿真控制台(趋势 182)、一个图生图工具(趋势 150)、一个换脸应用(趋势 132,568 喜欢)。这类"开箱即用"的界面仍然是社区里点开率最高的东西。
6. 价格与上下文
6.1 本周新增
OpenRouter 全站 464 个条目,剔掉 7 个用负数占位价的路由模型后是 457 个。本期窗口内新增 6 个条目,去重掉批处理版本后是 4 个独立模型。
| 模型 | 上线 | 上下文 | 输入价 | 输出价 |
|---|---|---|---|---|
| recursive/flint-v1.0:free | 10-22 | 262K | 免费 | 免费 |
| moonshotai/kimi-k3.1-pro | 10-24 | 1.05M | $2.00 | $10.00 |
| openai/gpt-6.1-terra | 10-27 | 1.05M | $1.00 | $5.00 |
| openai/gpt-6.1-terra-pro | 10-27 | 1.05M | $1.00 | $5.00 |
价格单位是每百万 token。Terra 两个版本还有 batch 档,价格减半($0.50 / $2.50)。四个模型里三个支持 100 万以上上下文,这个比例和上期一致。
值得留意的是同一家厂商的定价结构:GPT-6.1 Terra 用 1.05M 上下文配 $1/$5,比它自家的 GPT-5.6 Terra($2/$12)便宜一半;Kimi K3.1 Pro 则是 $2/$10,输出价比 Terra 贵一倍。
6.2 价格分层
全部 457 个报价条目按上下文档分四层,输出价中位数如下:
| 上下文档 | 模型数 | 输出价中位数 |
|---|---|---|
| 小于 128K | 71 | $1.00 |
| 128K–1M | 194 | $1.55 |
| 1M–2M | 190 | $4.25 |
| 2M 以上 | 2 | $2.50 |
混在一起算,输出价中位数是 $2.00,最低 $0.03(mistral-nemo)、最高 $600(openai/o1-pro),一头一尾差 2 万倍。1M 以上上下文的模型有 192 个,占 42%;免费模型 19 个。输出价不高于 $0.50 的有 101 个,不低于 $50 的有 19 个。
分层把这周的价目看得更清楚:1M 以上那一层的中位数 $4.25,是 128K 以下那层($1.00)的四倍多。长上下文仍然是要加钱的,但不是所有厂商都这么算——Terra 把 1.05M 压到 $1/$5,落在 1M 层的中位数以下。最贵的那档反而是 200K 上下文的 o1-pro,$150/$600,说明定价逻辑里"能力"和"窗口"是两个独立的加价项。
7. 本周发布
OpenAI 在 10 月 26 日发了 GPT-6.1 Terra,官方的一句话说明是"把快速、可用的 computer use 带给所有人";10 月 27 日它就上了 OpenRouter,1.05M 上下文、$1/$5。在 Artificial Analysis 的综合指数里,它一进来就排到第 10(48.11 分),但 LMArena 这期快照停在 10 月 22 日,所以总榜里还看不到它——下周才有得比。
月之暗面的 Kimi K3.1 Pro 稍早:网页生成榜 10 月 23 日就有它的记录(1,691.6 分、第 8),OpenRouter 10 月 24 日上架,$2/$10、1M 上下文。综合指数那边它排第 4,是中国厂商在这一期里的最高位。
Anthropic 这周没有可查的官方公告,Claude Haiku 5.5 只是第一次被 LMArena 测到(第 153 名),OpenRouter 上 10 月 8 日就有货,所以算补测而不是发布。
Google 这周没有新模型,只有 10 月 26 日教育侧的 AI Quest(主题是人脑图谱)和 10 月 21 日那份东南亚数字经济报告。OpenAI 的其余动作集中在渠道:10 月 21 日宣布模型将进入 Google Cloud,10 月 27 日与 Oracle 合作把企业应用接进 ChatGPT,ChatGPT Ads 同期扩到 26 个国家——都是分发和商业化,不是能力。
Hugging Face 博客这周的模型向内容是 IBM 的 Granite Speech 5.0(10 月 21 日,语音转写、翻译与说话人归属)、微软的 ThinkingBox(10 月 22 日,把数据库评分做成 RL 奖励),以及 NVIDIA Kumo Relational(10 月 21 日,关系型数据上免训练的模型)。
8. 本期观察
第一,榜首的"稳"只是因为没被考。 Gemini 4 Argon 前几期票数冻在 4,900,分数就一直停在 1,532 附近;这周补进 5,183 张票,立刻掉 6.6 分,四个类别同步下跌。高票数模型 1 分的变动才值得看,低票数模型的稳定往往只是没人测。
第二,周环比现在才算能读。 上期因为命名口径切换,47 个历史模型被当成新条目重新登记,那种表根本没法算变化。这一期归一后只剩 1 个真新条目,名次位移也缩小到 ±3 位以内,数据终于干净到可以做周对比。
第三,长上下文还在加价,但已经开始有厂商不这么算。 1M 以上那一层的输出价中位数是 $4.25,128K 以下只有 $1.00;同时 Terra 用 $1/$5 给出了 1.05M 的窗口。窗口大小从"卖点"变成"配置项",只是价格表还没统一。
第四,开源权重的位置在前 40 里稳定下来了。 总榜第 11 的 MiMo-V2.6-Pro(MIT)、第 27 的 GLM-5.3(MIT)、第 37 的 DeepSeek-V4.1-Flash 都在前 40;编码榜里 MiMo-V2.6-Pro 排到第五,和第四名只差 0.07 分。第一梯队仍然闭源,但"够用"这条线已经落在能自托管的位置。
9. 数据说明
本文的能力排名来自 LMArena 的社区盲测:用户同时看到两个匿名模型的回答,投票选出更好的那个,再用大量对战结果拟合成 Elo 分数。分数本身没有绝对含义,只有相对意义——1,525.7 分不代表"1,525.7 分的水平",只代表在这批模型里排第一。
读这张榜要注意三件事。
一是看票数。 票数少的新模型分数波动大,前 20 名模型的 95% 置信区间半宽中位数是 4.6 分,所以本文表格里 ±1 分的"周变化"基本等于没动;票数上万的模型,1 分的变动才值得注意。
二是看类别。 总榜、编码、中文、数学各自独立拟合,分数不能跨类别比较。网页生成的第一名 1,806.9 分不是"比总榜第一名强 280 分",而是另一套评分体系里的另一个位置。中文、数学这类子榜的票数只有几百,结论要打折扣。
三是看偏向。 盲测用户以英文使用者为主,题目偏通用对话和编码,擅长这两类的模型天然占优;多模态、长上下文、工具调用这些能力,在这张榜上体现得很有限。视觉榜和文生图榜是独立的数据集,更新节奏也不一样——这期视觉榜停在 10 月 19 日,文生图榜 10 月 26 日才更新。
时间窗是 2026 年 10 月 21 日到 27 日,Elo 变化按窗口内最后一次快照(10 月 22 日)与它上一次快照(10 月 20 日)计算,两次快照间隔两天而不是七天,所以"周变化"要理解成"本期变化"。两周前榜单把模型标识从内部 slug 改成了展示名,切换期间同一批历史模型曾被当作新条目重新登记,本期已基本完成归一,只剩一个真补测条目。开源侧的趋势分是近期相对热度,下载量是滚动 30 天口径,两者不能互相替代。第 1 节的能力指数是另一套评分体系,和 Elo 只能各自纵向比较,不能换算。
版权声明:如无特殊说明,文章均为本站原创,转载请注明出处
本文链接:https://tendcode.com/subject/article/ai-weekly-20261027/
许可协议:署名-非商业性使用 4.0 国际许可协议