这一周的榜首换人了,而且换得突然:Gemini 4 Carbon 在 10 月 28 日的 LMArena 快照里第一次出现,就带着 4,403 张票站到第一,把上期第一的 Gemini 4 Argon 挤到第二。但它还处在预发布测试阶段,票数也只有 Argon 的三分之一——这个第一能站多久,要看后面几周。下面先看另一套口径的能力指数,再回到 2026 年 10 月 28 日到 11 月 3 日的 LMArena 读数。
1. 能力指数 TOP30
口径
下面这张图是另一套东西:Artificial Analysis 的 Intelligence Index,把十来项评测合成一个 0–100 的分数。它和后文 LMArena 的 Elo 不可换算,也不能放进一句话里比大小,两个榜各自纵向读。
开头先看图。这张榜衡量的是固定评测集上的综合表现,和社区盲投出来的 Elo 是两种采样方式,只用来做横向的构成对照。
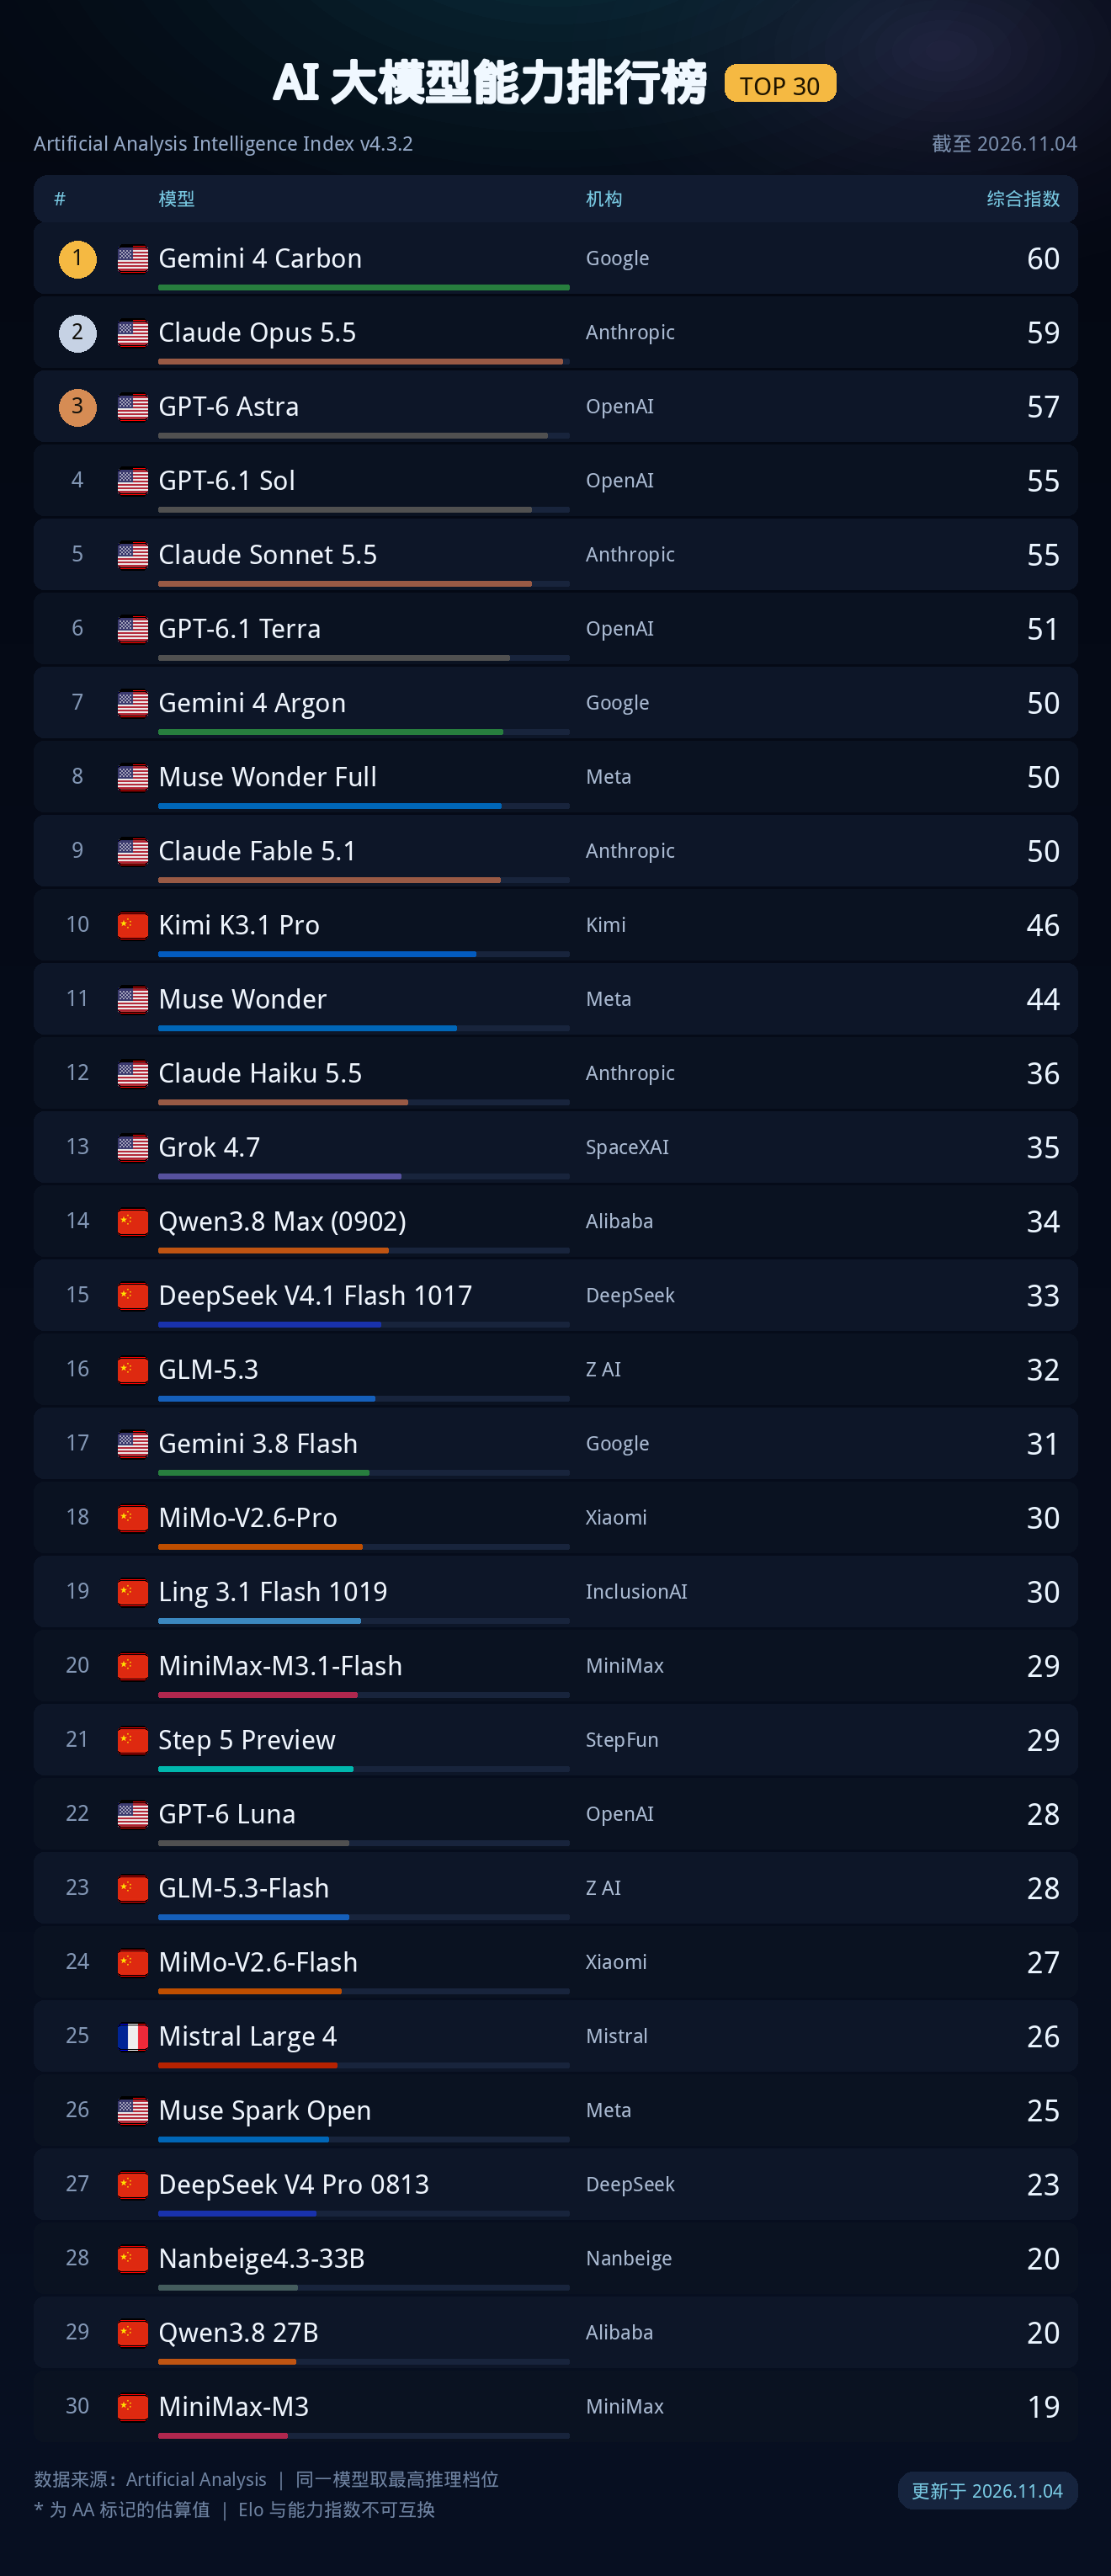
四条对照观察:
头部构成:前五里 Anthropic 两席(Claude Opus 5.5 59.11、Claude Sonnet 5.5 54.54),OpenAI 两席(GPT-6 Astra 56.85、GPT-6.1 Sol 54.61),Google 一席(Gemini 4 Carbon 60.03 排第一)。上期前五里的 Muse Wonder Full 退到第 8、Kimi K3.1 Pro 退到第 10,位置被 OpenAI 的两个模型接走。
中国厂商密度:前 30 名里中国厂商 14 席,和上期持平,接近一半。
开源最高位:前 30 里开放权重模型占 14 个,最高的是第 15 的 DeepSeek V4.1 Flash 1017(32.59),接着是第 16 的 GLM-5.3(31.65)和第 18 的 MiMo-V2.6-Pro(29.89)。这三家在 LMArena 总榜上也都在前 50。
梯队落差:前 9 名都在 50 分以上,第 9 名(50.02)到第 10 名(46.45)之间隔了 3.57 分;但前 30 里最大的一道断层在第 11 名(43.57)和第 12 名(36.48)之间,整整 7.09 分。榜尾第 30 名是 18.88 分。
图上两个前提要交代:同一个模型的不同推理档位只取最高分,所以分数不代表默认调用的表现;带 * 的是 AA 标注的估算值,这一期前 30 里没有。图上的"截至"写的是 11 月 4 日,比本文的数据窗口多一天。
2. 本期速览
- 分数最高:Gemini 4 Carbon (High),1,540.0 分,4,403 票。它 10 月 28 日才进榜,第一个快照就排到第一。
- 投票最多:Gemini 3.1 Pro Preview 的 132,547 票(第 20 名);前 20 名合计 842,584 票,其中 Anthropic 占九席。
- 厂商分布:前 50 名里 Anthropic 13 席、Google 11 席,Meta 与 OpenAI 各 5 席,中国厂商合计 16 席。
| 排名 | 模型 | 厂商 | Elo | 周变化 | 投票数 | 上期 |
|---|---|---|---|---|---|---|
| 1 | Gemini 4 Carbon (High) | 1,540.0 | 新 | 4,403 | 新 | |
| 2 | Gemini 4 Argon (High) | 1,528.6 | +2.9 | 11,889 | #1 | |
| 3 | Claude Opus 5.5 (High) | Anthropic | 1,515.8 | -0.4 | 11,415 | #2 |
| 4 | Claude Fable 5.1 (Max) | Anthropic | 1,513.8 | +1.3 | 17,178 | #3 |
| 5 | Claude Opus 5 (Max) | Anthropic | 1,507.9 | -0.4 | 35,531 | #4 |
| 6 | Claude Opus 5 (High) | Anthropic | 1,504.1 | +0.8 | 73,167 | #5 |
| 7 | Claude Opus 4.6 (High) | Anthropic | 1,501.7 | +0.3 | 84,512 | #6 |
| 8 | Muse Wonder (Max) | Meta | 1,499.2 | -1.4 | 7,749 | #7 |
| 9 | Gemini 3.8 Flash (High) | 1,498.5 | +0.2 | 47,803 | #8 | |
| 10 | Claude Opus 4.6 | Anthropic | 1,496.2 | -0.6 | 89,324 | #9 |
| 11 | Claude Fable 5 (High) | Anthropic | 1,491.6 | +0.6 | 45,341 | #12 |
| 12 | MiMo-V2.6-Pro | Xiaomi | 1,491.4 | +0.3 | 4,037 | #11 |
| 13 | Muse Spark 1.3 (Max) | Meta | 1,490.6 | -0.5 | 22,134 | #10 |
| 14 | Claude Opus 4.7 (High) | Anthropic | 1,489.7 | 持平 | 65,110 | #13 |
| 15 | Gemini 3.7 Flash (High) | 1,489.1 | -0.4 | 32,289 | #14 | |
| 16 | Qwen3.8-Max | Alibaba | 1,483.3 | -0.3 | 31,915 | #15 |
| 17 | Claude Opus 4.7 | Anthropic | 1,483.0 | 持平 | 66,140 | #16 |
| 18 | Muse Spark 1.2 (xHigh) | Meta | 1,482.7 | +0.8 | 11,724 | #17 |
| 19 | Gemini 3.5 Flash (High) | 1,482.2 | +0.3 | 48,376 | #18 | |
| 20 | Gemini 3.1 Pro Preview | 1,480.1 | -0.1 | 132,547 | #19 |
3. 总榜变动
3.1 头部变化
这一期的头部只有一个动作:Carbon 空降。它拿到的第一个分数是 1,540.0,比第二名的 Argon 高 11.4 分。但这个领先不算宽裕——4,403 张票对应的 95% 置信区间是 ±9.35 分(1,530.7 到 1,549.4),而前 20 名模型的区间半宽中位数只有 4.66 分。它的区间下界 1,530.7 只比 Argon 的 1,528.6 高 2.1 分,再多几百张票往哪边倒,结论都可能变。
Argon 自己其实也涨了:+2.9 分到 1,528.6,票数从 10,083 涨到 11,889,一周补进 1,806 张。分项上创意写作 +4.4、指令遵循 +5.0、长查询 +4.3、难题 +3.7,编码 -1.1、多轮对话 -4.8、中文与数学基本没动。它的问题不是变差,是来了一个分数更高的。
第三名 Claude Opus 5.5 (High) 掉 0.4 分到 1,515.8,第四名 Claude Fable 5.1 (Max) 涨 1.3 分到 1,513.8,两者只差 2.0 分。
第 11 到 13 名是一次贴着的换位:Claude Fable 5 (High) #12 → #11,1,491.6(+0.6);MiMo-V2.6-Pro #11 → #12,1,491.4(+0.3);Muse Spark 1.3 (Max) #10 → #13,1,490.6(-0.5)。三个模型挤在 1.0 分里,这种位置互换基本等于没动。
3.2 中段换手
先说前提:这期前 80 名最大位移只有 5 位,前 150 名里只有 18 个模型的名次和上期完全一致。这不是榜单集体变了,而是一个新条目插在第一位,把后面每一个模型都往下压了一位。下面两张表的名次变化,要先扣掉这一位的插入效应再看。
上升
| 模型 | 名次变化 | Elo 变化 |
|---|---|---|
| Step 5 Preview | #74 → #69 | +0.7 |
| GPT-6.1 Sol (Max) | #66 → #62 | +1.5 |
| Hy3 | #80 → #77 | +0.6 |
| Claude Fable 5 (High) | #12 → #11 | +0.6 |
下降
| 模型 | 名次变化 | Elo 变化 |
|---|---|---|
| ERNIE-5.0-Preview (1203) | #69 → #74 | -0.2 |
| Kimi K2.5 (Thinking) | #61 → #65 | -0.1 |
| Dola Seed 2.0 Pro | #54 → #57 | -0.2 |
| Muse Spark 1.3 (Max) | #10 → #13 | -0.5 |
把插入的这一位扣掉,前 80 名的真实换手也就是五六位:Step 5 Preview 从 #74 走到 #69,净升 6 位;ERNIE-5.0-Preview (1203) 从 #69 掉到 #74,净降 4 位。这些模型的 Elo 变动都在 ±1.5 分以内——前 20 名区间半宽中位数是 4.66 分,差距全在噪声范围里。前 80 名里除了 Argon,这周涨分最多的是 GPT-6.1 Sol (Max) +1.5 和 Claude Fable 5.1 (Max) +1.3;跌得最多的是 Muse Wonder (Max) -1.4 和 GPT-6 Astra (Max) -0.9。
3.3 新条目辨析
这一期总榜多了 1 个条目:Gemini 4 Carbon (High),直接落在第 1 名。上期的 416 个条目全部对上了,没有掉榜。
这次不用辨析"新条目是不是新模型"——它就是新模型。Artificial Analysis 的发布记录把 Carbon 的发布日期写成 2026 年 10 月 28 日,它也确实是在 10 月 22 日之后的这份快照里才第一次出现;Google 11 月 2 日的月度汇总,把 Carbon 列进了 10 月的前沿模型动作。
不过它还不是全面开放。Google 的说法是 Carbon 正在跟美国政府和 Fairwind Program 的一批网络防御伙伴做预发布测试,测试完再扩大范围;OpenRouter 的价格表里也查不到它的条目。所以"第一名"目前只代表第一批测试对局的结果。
辨析
两周前因为模型标识从 slug 改成展示名,榜单上曾一次冒出 47 个"新条目"。这一期没有残留:417 个条目里 416 个与上期一一对应,唯一的新条目是能查到官方发布日期的真新模型。判断"新条目是不是新模型",现在看发布记录就够,不必再靠名字猜。
4. 分项榜
4.1 编码与网页生成
| 类别 | 前三 | Elo | 投票数 |
|---|---|---|---|
| 编码 | Gemini 4 Carbon (High) | 1,569.5 | 1,106 |
| 编码 | Claude Opus 5.5 (High) | 1,547.2 | 2,555 |
| 编码 | Gemini 4 Argon (High) | 1,538.2 | 2,813 |
| 网页生成 | Claude Opus 5.5 (Max) | 1,809.8 | 3,473 |
| 网页生成 | GPT-6 Astra (Max) | 1,773.4 | 7,210 |
| 网页生成 | Claude Sonnet 5.5 (xHigh) | 1,769.7 | 4,469 |
编码榜换了第一:Carbon 1,569.5,领先 Claude Opus 5.5 22.3 分;上期的第一 Argon 掉到第三(-1.1,1,538.2)。第四名是 MiMo-V2.6-Pro,1,533.5(+1.0,1,091 票),第五名 Claude Opus 4.6 是 1,533.4——两者只差 0.1 分,开源权重离前四就卡在这个缝里。
网页生成榜 Carbon 只排第四(1,768.2,2,230 票),前三还是 Opus 5.5 (Max)、GPT-6 Astra (Max)、Sonnet 5.5 (xHigh)。再看两个子榜:webdev-html 第一是 GPT-6.1 Sol (Max) 1,795.8(711 票),Carbon 第三(1,779.8,252 票);webdev-react 第一是 Opus 5.5 (Max) 1,859.5。
网页生成的分数比总榜高出近 270 分,这是另一套独立拟合的体系,不能和总榜横向比。
4.2 中文与数学
| 类别 | 前三 | Elo | 投票数 |
|---|---|---|---|
| 中文 | Gemini 4 Carbon (High) | 1,616.2 | 474 |
| 中文 | Gemini 4 Argon (High) | 1,600.2 | 918 |
| 中文 | Claude Opus 5.5 (High) | 1,583.1 | 1,026 |
| 数学 | Gemini 4 Argon (High) | 1,538.5 | 674 |
| 数学 | Gemini 4 Carbon (High) | 1,536.2 | 207 |
| 数学 | Claude Fable 5.1 (Max) | 1,531.0 | 835 |
中文第一换成了 Carbon,1,616.2,领先 Argon 16.0 分。数学第一还是 Argon(1,538.5,674 票),Carbon 以 1,536.2 排第二,差 2.3 分——这是 Carbon 在这期唯一没拿到的通用类目第一。数学榜第 3 到第 5 名(Fable 5.1 1,531.0、Opus 5 (High) 1,531.0、Opus 5 (Max) 1,530.5)挤在 0.5 分里,基本是并列。
这两个榜的票数还是薄:中文第一 474 票,数学第一 674 票,Carbon 在数学上只有 207 票。2 分上下的差距在几百票的样本里说明不了太多,这一节看结构比看名次有用。
4.3 视觉与文生图
视觉理解这份榜在本文窗口内没有新快照,最近一次停在 10 月 19 日。前三仍是 Claude 系:Claude Fable 5 (High) 1,324.9(14,714 票)、Claude Opus 5.5 (High) 1,320.8(3,035 票)、Claude Opus 5 (High) 1,319.6(17,743 票)。
文生图榜停在 10 月 26 日,也没有新读数。前三名是 GPT-Image-2.5 Sunburst 1,427.4(40,323 票)、GPT-Image-2.5 Flare 1,401.3(39,218 票)、GPT-Image-2 (Medium) 1,381.3(103,385 票),第四是 MAI-Image-2.6 1,328.6(34,596 票),第五是 Gemini Nano Banana 2.1 1,325.2(5,290 票)。
图像编辑榜停在 10 月 27 日,比窗口早一天,第一还是 Sunburst(1,516.8,90,545 票)。这三份快照都是上期前后刚更新过的,这一周没有新东西可比,只能等下一次。
4.4 写作与指令遵循
创意写作第一是 Claude Opus 5.5 (High),1,534.4 分(2,672 票),Carbon 以 1,530.9 排第二(990 票),Argon 第三(1,527.4,2,720 票)。
指令遵循第一换成了 Carbon,1,539.2(1,484 票),只领先 Opus 5.5 的 1,538.9 零点三分,而对方的票数是它的 2.7 倍(3,950 对 1,484)。Argon 在这项是 1,532.6(4,236 票),第三。
把四项通用类目连起来看,Carbon 拿到编码、中文、指令遵循第一,创意写作和数学都排第二。它在"按指令做事"上已经领先,在"写得好看"和"算得准"上还差一点点。
5. 开源侧热度
5.1 模型
| 模型 | 趋势分 | 喜欢 | 30 天下载 | 类型 | 创建 |
|---|---|---|---|---|---|
| LiquidAI/LFM3-1.7B | 816 | 1,315 | 47,817 | 文本生成 | 10-23 |
| deepseek-ai/DeepSeek-V4.1-Flash-1017 | 649 | 4,787 | 187,260 | 图文理解 | 10-17 |
| nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B | 625 | 706 | 38,942 | 语音识别 | 10-07 |
| mistralai/Mistral-Large-4-1T-A52B | 520 | 1,522 | 6,556 | 图文理解 | 09-30 |
| speridlabs/idol | 442 | 464 | 10,742 | 图生 3D | 10-28 |
| Lightricks/LTX-2.5 | 381 | 10,418 | 2,488,128 | 图生视频 | 07-23 |
| ccore/Qwen3.5-4B-3D-Coder | 374 | 579 | 91,123 | — | 10-25 |
| Pika-Labs/Pika-H3-Flex | 351 | 373 | 633 | 图生视频 | 10-29 |
| baidu/Unlimited-OCR-2 | 349 | 576 | 189,897 | 图文理解 | 10-26 |
| LiquidAI/LFM3-Omni-2B | 293 | 324 | 11,662 | 全模态 | 10-21 |
趋势榜第一换成了 LiquidAI/LFM3-1.7B(816 分,10 月 23 日建),一家小模型厂商一周内占了两席——LFM3-Omni-2B 也在第十。DeepSeek-V4.1-Flash-1017 掉到第二(649 分),热度还在高位,但从峰值退下来了。
往下看更有意思:speridlabs/idol 10 月 28 日建仓,一周 442 分,做的是图生 3D;Pika-H3-Flex 10 月 29 日建仓拿到 351 分,但 30 天下载只有 633——趋势分高、下载少,说明大家在围观还没上手。baidu/Unlimited-OCR-2 正好相反,趋势 349 分,下载 18.9 万,是已经在用的那一类。
LTX-2.5 的 248.8 万下载和 10,418 个喜欢、Mistral-Large-4 的 6,556 下载配 1,522 个喜欢,都是累计出来的数字,不能当本周热度看。趋势分是近期相对增速,下载量是滚动 30 天口径,两列要分开读。
5.2 数据集与 Space
数据集第一还是 nvidia/simready-assets(趋势 527,123.8 万下载,1,343 喜欢),第二是网络安全数据集 Vyber07/cyber-security(175),第三是 open-index/hacker-news(90,45.3 万下载)。第四、第五都跟仿真资产有关:scenario-labs/3d-collection(65,4.0 万下载)和 10 月 28 日新建的 codepawl/simready-glb(58,1.6 万下载)。
Space 榜前五里也有一席是同一个方向:nvidia/simready-central(趋势 126,360 喜欢)。其余四席被图像和视频占满——qwen-image 的 LoRA 工作流(163,243 喜欢)、Wan 模型的可视化界面 wan777(132,1,248 喜欢)、一个换脸应用(97,718 喜欢),以及刚建的 speridlabs/idol(95,101 喜欢)。
把两个榜放在一起看,物理仿真资产这一周占了数据集前五的三席,这在过去几期没见过。它和榜单本身没关系,但和 NVIDIA 这两周在机器人、仿真方向的动作是同一条线。
6. 价格与上下文
6.1 本周新增
OpenRouter 全站 454 个条目,剔掉 7 个用负数占位价的路由模型后是 447 个。本期窗口内新增 3 个条目,比上期的 6 个少了一半,三个都支持 100 万以上上下文。
| 模型 | 上线 | 上下文 | 输入价 | 输出价 |
|---|---|---|---|---|
| particle-ai/particle-1 | 10-29 | 1.05M | $0.05 | $0.50 |
| z-ai/glm-5.3-flashx-legal | 11-02 | 1.05M | $0.37 | $1.25 |
| stealth/crouton-alpha | 11-03 | 1.05M | 免费 | 免费 |
价格单位是每百万 token。particle-1 的 $0.05/$0.50 是这一期付费新增里最低的一档,输出价只有 1M 上下文那一层中位数($3.75)的 13%。glm-5.3-flashx-legal 是带 legal 后缀的变体,$0.37/$1.25。
第三条要单独说一下:stealth/crouton-alpha 是匿名条目,输入支持文本、图片、文件、音频、视频,1.05M 上下文,标价为零。条目里没有任何厂商信息——它和本周榜首之间没有可核实的对应关系,这里只记事实,不做推断。
6.2 价格分层
全部 447 个报价条目按上下文档分四层,输出价中位数如下:
| 上下文档 | 模型数 | 输出价中位数 |
|---|---|---|
| 小于 128K | 40 | $0.78 |
| 128K–1M | 211 | $1.25 |
| 1M–2M | 194 | $3.75 |
| 2M 以上 | 2 | $2.50 |
混在一起算,输出价中位数是 $2.00,最低 $0.03(mistral-nemo)、最高 $180(openai/gpt-5.4-pro),一头一尾差 6,000 倍。1M 以上上下文的模型有 196 个,占 43.8%;免费条目 18 个,付费 429 个。输出价不高于 $0.50 的有 119 个,不低于 $50 的有 17 个。
分层看,1M 那一层的中位数 $3.75 是 128K 以下那层($0.78)的 4.8 倍,长上下文仍然要加钱。但这一期新增的三条全是 1.05M,最贵的输出价也只有 $1.25——新进来的模型不再拿"长窗口"当溢价理由,而是把它当默认配置。2M 以上那一层只有 2 个条目,样本太小,不解读。
7. 本周发布
Google 这一周发了 Gemini 4 Carbon。Artificial Analysis 的发布记录写的日期是 10 月 28 日,LMArena 也是在 10 月 22 日之后的这份快照里第一次收录它。官方定位是长周期工程和网络安全防御,Google 称这是它目前最强的模型。但它现在只在美国政府和 Fairwind Program 的一批网络防御伙伴那里做预发布测试,扩大范围要等安全护栏调完。LMArena 的 10 月 28 日快照里已经有它 4,403 张票,说明测试方在投;OpenRouter 上没有它的报价,也说明它没到公开售卖那一步。
OpenAI 这周没有新模型。官方博客 RSS 在窗口内 22 条,全是安全、政策和企业向:安全冲刺(11 月 3 日)、提高漏洞赏金(11 月 3 日)、更新 Model Spec(10 月 30 日)、让网站表达 AI 训练偏好(10 月 30 日),以及 Cisco、Heimstaden、Legora、ServiceNow 的落地案例。上期上架的 GPT-6.1 Terra,在这期 10 月 28 日的快照里仍然没有条目——榜单收录比 API 上架慢一步。
开源侧这周有几件事。Mistral Large 4 的权重 10 月 29 日上了 Hugging Face(官方博客把它叫 Le Chonk),它在 LMArena 总榜第 95(1,430.1,12,066 票),在能力指数榜第 25(26.12)——早就在榜上,这周只是权重可下载了。IBM 10 月 29 日发了 Granite Switch 4.1.1,主打"像更新软件一样更新模型"的版本化思路。Liquid AI 的 LFM3 系列 10 月 28 日发布,小尺寸的 1.7B 和 2B 两个规格,趋势榜第一就是它。
Hugging Face 博客 11 月 3 日还有两篇偏工程的:CWE-bench v2(代码安全评测,扩大了覆盖)和 Transformers Model Integration Contracts(模型集成的契约规范)。这两篇不是发布,但会影响接下来一批模型的接入方式。
8. 本期观察
第一,换榜首不等于换梯队。 Carbon 的 1,540.0 比 Argon 高 11.4 分,看着像断层,但它的区间是 ±9.35 分,票数只有 4,403 张,是 Argon 的 37%。同期前 20 名的区间半宽中位数是 4.66 分——一个票数不足对手四成的新模型,它的 11.4 分领先,要比老模型之间 0.5 分的差距更谨慎地看。等它票数上到万级,这个分数才算数。
第二,名次普跌一位是插入效应,不是集体退步。 前 150 名里只有 18 个模型名次没变,看着像大洗牌;但把新条目这一位扣掉,真实的换手是净升 6 位、净降 4 位,Elo 变动都在 ±1.5 分内。Argon 自己还涨了 2.9 分。读周榜时,"掉了两名"和"掉了两名还跌分"是两件事。
第三,两套口径给出的排名可以差出一百多位。 GPT-6 Astra 在能力指数榜排第 3,在 LMArena 排第 75;Grok 4.7 是第 13 和第 158;Claude Haiku 5.5 是第 12 和第 154。原因不神秘:能力指数用固定评测集,一次跑完就有分;LMArena 要真人投票,新模型票数不够时排位会很低。想知道"标准答案做得好不好"看前者,想知道"人更喜欢哪个回答"看后者,两者都不是"真实能力"的完整画像。
第四,Agent 榜这周更新了,成本和能力不是一条线。 11 月 2 日的新快照里,Claude Opus 5.5 (Max) 以 0.2004 排第一,每任务成本 $6.82;Gemini 4 Carbon (High) 0.1656 排第二,每任务 $1.73,在前六里只比 GPT-6.1 Sol (Max) 的 $0.96 贵;GPT-6.1 Sol (Max) 0.1224 排第六,$0.96。这个榜用的是 0–1 的任务维度分数,不是 Elo,不能和总榜并列。但它给出了总榜没有的信息:Carbon 在"便宜"和"接近最强"之间是目前最靠前的一个点。
9. 数据说明
本文的能力排名来自 LMArena 的社区盲测:用户同时看到两个匿名模型的回答,投票选出更好的那个,再用大量对战结果拟合成 Elo 分数。分数本身没有绝对含义,只有相对意义——1,540.0 分不代表"1,540.0 分的水平",只代表在这批模型里排第一。
读这张榜要注意三件事。
一是看票数。 票数少的新模型分数波动大。这期第一名只有 4,403 票,区间 ±9.35 分;而前 20 名的区间半宽中位数是 4.66 分。表格里 ±1 分的"周变化"基本等于没动,票数上万的模型,1 分的变动才值得注意。
二是看类别。 总榜、编码、中文、数学各自独立拟合,分数不能跨类别比较。网页生成的第一名 1,809.8 分不是"比总榜第一名强 270 分",而是另一套评分体系里的另一个位置。中文、数学这类子榜的票数只有几百,结论要打折扣。
三是看偏向。 盲测用户以英文使用者为主,题目偏通用对话和编码,擅长这两类的模型天然占优;多模态、长上下文、工具调用这些能力,在这张榜上体现得很有限。视觉、文生图、图像编辑是独立的数据集,更新节奏也不一样:这期它们分别停在 10 月 19 日、10 月 26 日和 10 月 27 日。
时间窗是 2026 年 10 月 28 日到 11 月 3 日,Elo 变化按窗口内最后一次快照与它上一次快照计算1。"周变化"因此要理解成"本期变化",不一定是整整七天。榜单在 10 月中旬把模型标识从内部 slug 改成了展示名,切换期间同一批历史模型曾被当作新条目重新登记;这期把名称归一之后,417 个条目里 416 个与上期对上2,只剩一个新条目,且是官方发布记录能核实的新模型。
开源侧的趋势分是近期相对热度,下载量是滚动 30 天口径,两者不能互相替代。第 1 节的能力指数是另一套评分体系,和 Elo 只能各自纵向比较,不能换算——它也没有历史序列,做不了周环比。
版权声明:如无特殊说明,文章均为本站原创,转载请注明出处
本文链接:https://tendcode.com/subject/article/ai-weekly-20261103/
许可协议:署名-非商业性使用 4.0 国际许可协议