这一周的榜首没换,前十也基本没动,唯一值得记的动作发生在榜单边缘:Kimi K3.1 Pro 带着 3,443 张票空降到第 44 名。窗口里 LMArena 连发了三次快照,日更节奏把"周变化"压成了零点几分的抖动——这期先把这件事说清楚,再回到 2026 年 11 月 4 日到 10 日的读数。
1. 能力指数 TOP30
口径
下面这张图是另一套东西:Artificial Analysis 的 Intelligence Index,把十来项评测合成一个 0–100 的分数。它和后文 LMArena 的 Elo 不可换算,也不能放进一句话里比大小,两个榜各自纵向读。
开头先看图。这张榜衡量的是固定评测集上的综合表现,和社区盲投出来的 Elo 是两种采样方式,只用来做横向的构成对照。
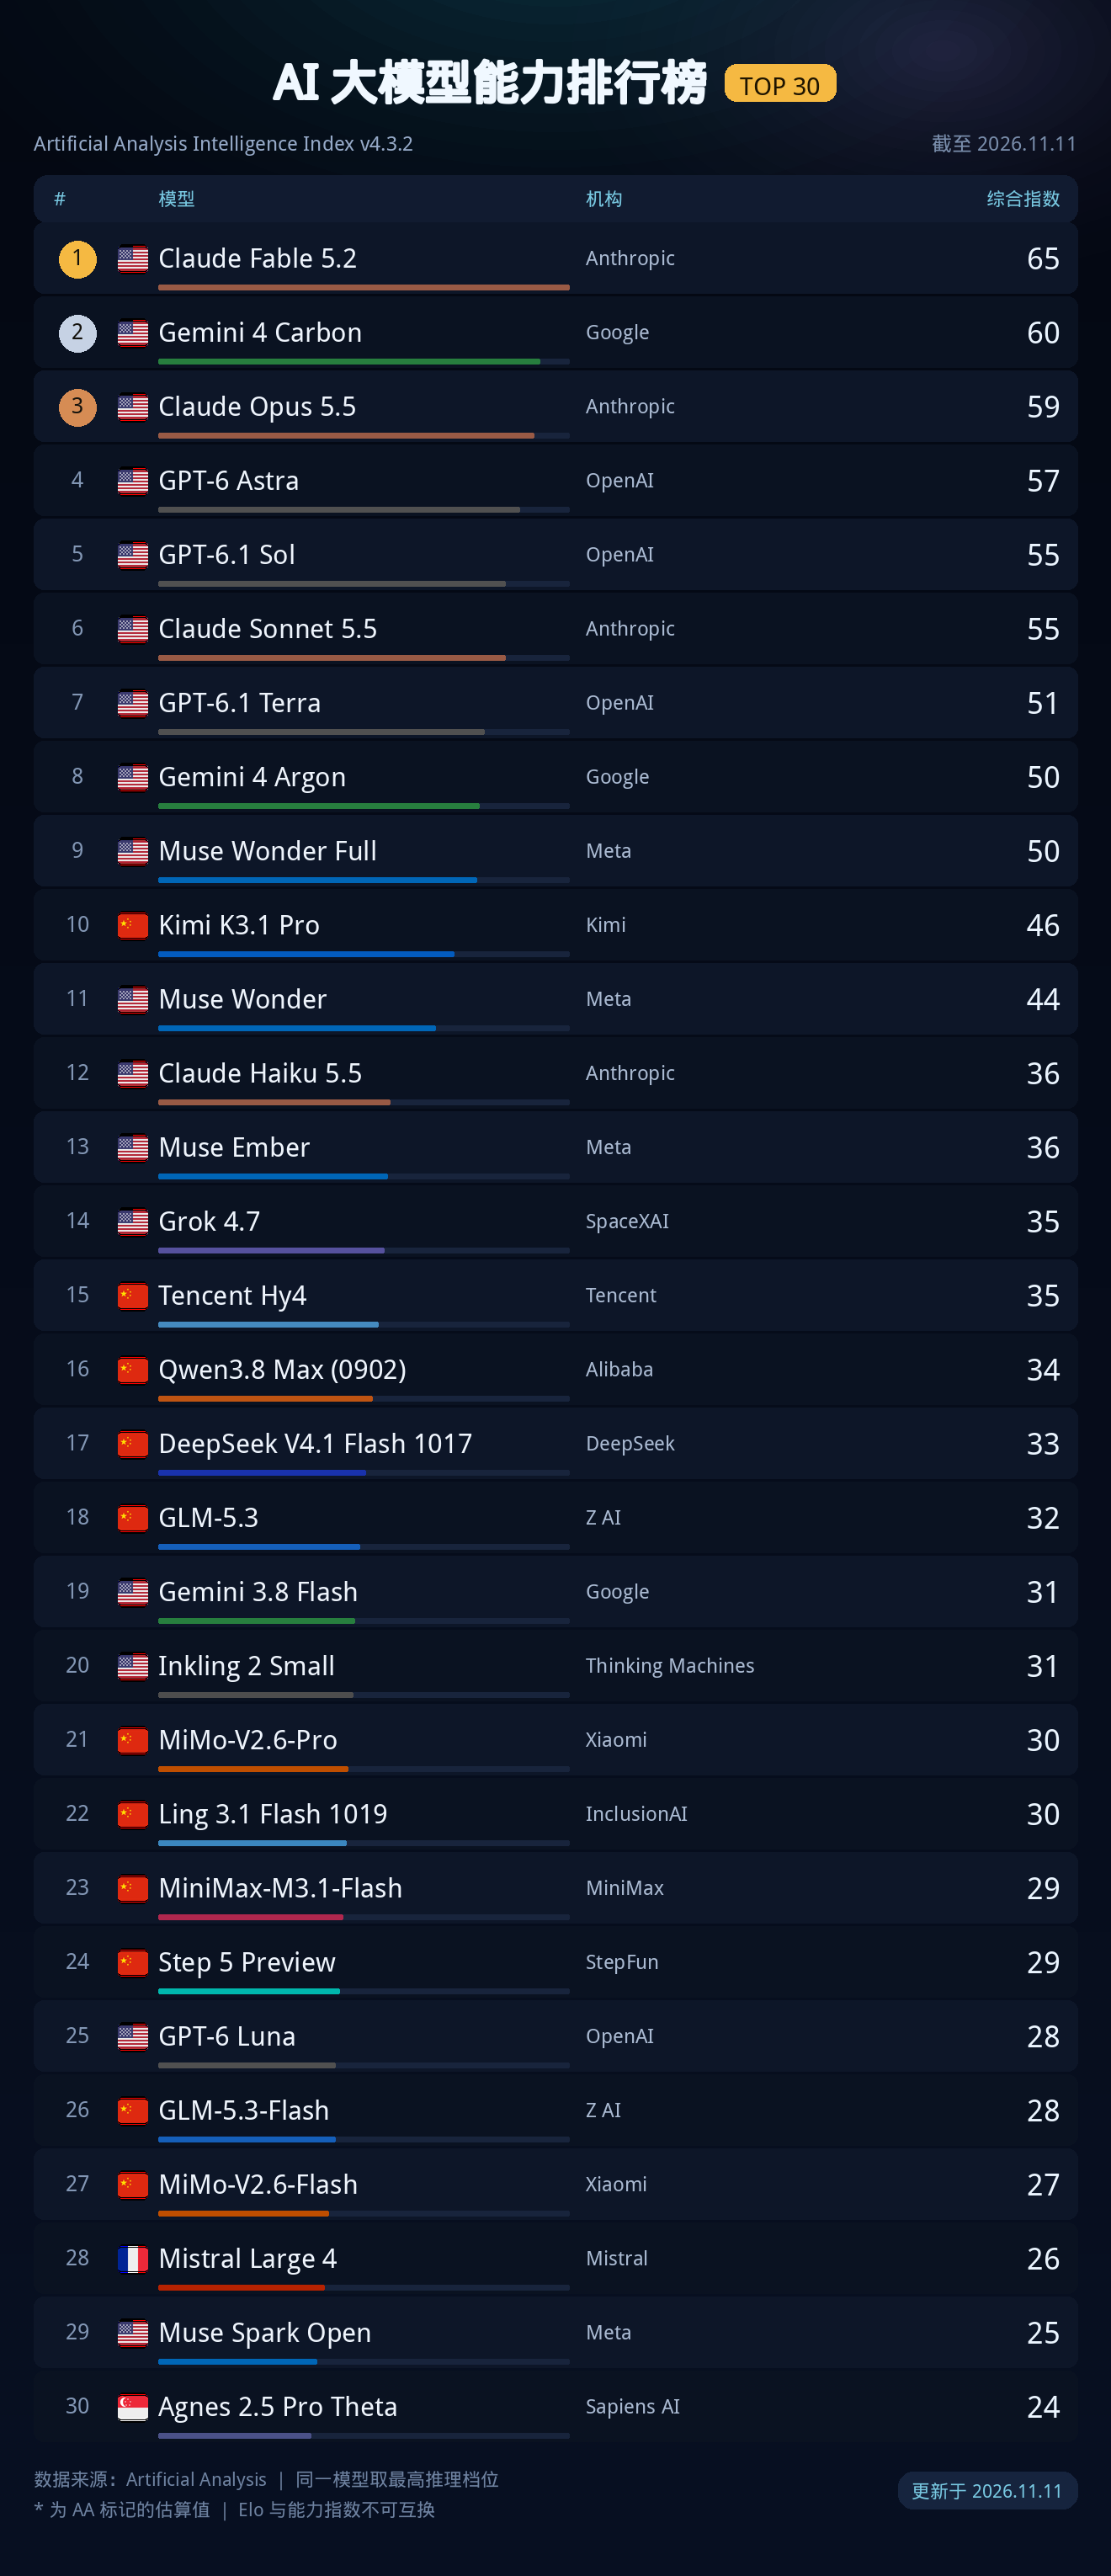
四条对照观察:
头部构成:Claude Fable 5.2 以 64.56 分排第一,比第二名 Gemini 4 Carbon 的 60.03 高 4.53 分。上期排第一的是 Carbon,这一期被挤到第二。前六里 Anthropic 三席(第 1、3、6)、OpenAI 两席(第 4、5)、Google 一席(第 2)。
中国厂商密度:前 30 名里中国厂商 11 席——Kimi 第 10、腾讯第 15、阿里第 16、DeepSeek 第 17、智谱第 18 和第 26、小米第 21 和第 27、InclusionAI 第 22、MiniMax 第 23、阶跃第 24。第 30 名是新加坡的 Sapiens AI。
开源最高位:开放权重里排最高的是第 10 的 Kimi K3.1 Pro(46.45)。前 30 里能核实为开放权重的至少 7 个:Kimi K3.1 Pro、DeepSeek V4.1 Flash 1017、GLM-5.3、GLM-5.3-Flash、MiMo-V2.6-Pro、MiMo-V2.6-Flash,以及法国的 Mistral Large 4。
梯队落差:前 9 名都在 50 分以上,第 9 名 50.08。榜上最大的一道断档还在第 11 名(43.57)和第 12 名(36.48)之间,7.09 分;第 5 名和第 6 名只差 0.07 分(54.61 对 54.54)。榜尾第 30 名是 24.03 分。
图上两个前提要交代:同一个模型的不同推理档位只取最高分,所以分数不代表默认调用的表现;带 * 的是估算值,这一期前 30 里没有。图上的"截至"写的是 11 月 11 日,比本文的数据窗口多一天。
2. 本期速览
- 分数最高:Gemini 4 Carbon (High),1,538.3 分,4,282 票,连续两期第一;领先第二名 Gemini 4 Argon 8.1 分。
- 投票最多:Gemini 3.1 Pro Preview 的 132,296 票(第 20 名);前 20 名合计 885,583 票,其中 Anthropic 占九席。
- 厂商分布:前 20 名 Anthropic 9 席、Google 6 席、Meta 3 席,小米与阿里各 1 席;前 50 名里中国厂商合计 16 席。
| 排名 | 模型 | 厂商 | Elo | 周变化 | 投票数 | 上期 |
|---|---|---|---|---|---|---|
| 1 | Gemini 4 Carbon (High) | 1,538.3 | -0.6 | 4,282 | #1 | |
| 2 | Gemini 4 Argon (High) | 1,530.2 | +0.4 | 19,787 | #2 | |
| 3 | Claude Opus 5.5 (High) | Anthropic | 1,513.0 | +0.3 | 15,249 | #4 |
| 4 | Claude Fable 5.1 (Max) | Anthropic | 1,512.4 | -0.4 | 20,087 | #3 |
| 5 | Claude Opus 5 (Max) | Anthropic | 1,506.3 | +0.1 | 35,710 | #5 |
| 6 | Muse Wonder (Max) | Meta | 1,503.0 | -1.2 | 12,032 | #6 |
| 7 | Claude Opus 5 (High) | Anthropic | 1,502.3 | -0.2 | 73,697 | #7 |
| 8 | Claude Opus 4.6 (High) | Anthropic | 1,501.7 | +0.1 | 84,424 | #8 |
| 9 | Gemini 3.8 Flash (High) | 1,500.4 | 持平 | 61,143 | #9 | |
| 10 | Claude Opus 4.6 | Anthropic | 1,496.7 | 持平 | 89,228 | #10 |
| 11 | MiMo-V2.6-Pro | Xiaomi | 1,491.7 | 持平 | 4,066 | #12 |
| 12 | Claude Fable 5 (High) | Anthropic | 1,491.6 | +0.1 | 45,524 | #11 |
| 13 | Muse Spark 1.3 (Max) | Meta | 1,491.5 | +0.3 | 26,111 | #13 |
| 14 | Claude Opus 4.7 (High) | Anthropic | 1,489.7 | +0.1 | 64,308 | #14 |
| 15 | Gemini 3.7 Flash (High) | 1,488.8 | +0.1 | 33,300 | #15 | |
| 16 | Qwen3.8-Max | Alibaba | 1,485.2 | -0.3 | 36,324 | #16 |
| 17 | Muse Spark 1.2 (xHigh) | Meta | 1,484.0 | -0.4 | 15,004 | #17 |
| 18 | Claude Opus 4.7 | Anthropic | 1,483.2 | +0.1 | 65,369 | #18 |
| 19 | Gemini 3.5 Flash (High) | 1,482.9 | +0.1 | 47,642 | #19 | |
| 20 | Gemini 3.1 Pro Preview | 1,480.0 | -0.1 | 132,296 | #20 |
表里的"周变化"和"上期",按相邻两次发布计算:11 月 8 日 → 11 月 9 日。窗口内其实有三份快照(11 月 6 日、8 日、9 日),这件事在第 3 节展开1。
3. 总榜变动
3.1 头部变化
这一期最该说清楚的不是"谁涨谁跌",而是节奏变了。窗口里总榜发了三次快照:11 月 6 日、8 日、9 日。表里取最后两次,中间只隔一天。
一天之内,前 20 名只换了两对位置。Claude Opus 5.5 (High) #4 → #3(1,513.0,+0.3),Claude Fable 5.1 (Max) #3 → #4(1,512.4,-0.4),两者差 0.6 分;MiMo-V2.6-Pro #12 → #11(1,491.7,持平),Claude Fable 5 (High) #11 → #12(1,491.6,+0.1),差 0.1 分。两组都在噪声里,算不上趋势。
榜首 Carbon 还在第一,但分数从 10 月 28 日的 1,540.0 掉到 1,538.3。它的票数是 4,282,一天只多了 1 张,比 12 天前的 4,403 还少 121 张——这份数据里的票数会被重算,不是只增不减的计数器。
真正能叫做"一周"的,要跨 12 天看。从上一期的 10 月 28 日快照算起:Muse Wonder (Max) 从 #8 走到 #6,涨 3.9 分(1,499.2 → 1,503.0),票数从 7,749 涨到 12,032;Claude Opus 5.5 跌 2.8 分,Claude Fable 5.1 跌 1.5 分;Gemini 4 Argon 涨 1.6 分,票数多了 7,898 张(11,889 → 19,787),是头部里票数涨得最多的。
但 Argon 还是追不上 Carbon:8.1 分的差距,对应的置信区间是榜首 ±9.54 分。
3.2 中段换手
先说结论:这一天里,前 80 名的最大位移是 3 位,前 150 名里有 48 个模型的名次完全没变。下面两张表就是全部"动过"的。
上升
| 模型 | 名次变化 | Elo 变化 |
|---|---|---|
| Claude Opus 5.5 (High) | #4 → #3 | +0.3 |
| Qwen3.5-Max-Preview | #31 → #30 | +0.1 |
| GPT-5.5 (High) | #30 → #29 | +0.1 |
| ERNIE-5.0-Preview (1203) | #73 → #71 | +0.1 |
下降
| 模型 | 名次变化 | Elo 变化 |
|---|---|---|
| GLM-5.3-Flash | #29 → #31 | -0.5 |
| GLM-5 | #59 → #61 | -0.1 |
| DeepSeek-V4-Pro Preview (High) | #62 → #64 | -0.1 |
| GPT-5.1 (High) | #70 → #72 | 持平 |
| Gemini 3 Flash (Minimal) | #71 → #74 | -0.1 |
这些位移都在 1~3 位、分数变动在 ±0.5 分内,基本等于没动。GPT-5.1 (High) 掉两位而分数持平,纯粹是后面有模型挤上来。
把窗口拉长到上一期也一样:前 80 名最大位移 5 位。跌得最多的是 Claude Sonnet 5.5 (xHigh),#30 → #34(-4.0 分);Gemma 4 31B #68 → #73(-0.4)、MiMo-V2.6-Flash #49 → #54(-0.9)。涨得最多的是 GLM-5.3 (Max) +2.2 分(#28 → #25)。
前 20 名的区间半宽中位数是 4.63 分。±4 分以内的变化,都还在误差范围内。
3.3 新条目辨析
总榜这一期 421 个条目。相对相邻的 11 月 8 日快照多 1 个,相对上一期的 10 月 28 日多 2 个:Inkling 2 Small 和 Kimi K3.1 Pro (Max)。419 个上期条目全部还在,没有掉榜的。
Kimi K3.1 Pro (Max) 是这期名次最高的新条目:#44,1,457.3 分,3,443 票。但它不是这周发的。10 月 23 日 OpenRouter 上就有 moonshotai/kimi-k3.1-pro($2/$10,1.05M 上下文),Hugging Face 上的仓库 11 月 2 日建好——它只是在 11 月 9 日的快照里第一次进榜。收录比上线晚了两到三周。
Inkling 2 Small 11 月 6 日的快照里第一次出现,排第 153 名(1,403.2 分)。能力指数榜上它已经拿到 30.63 分排第 20,说明是真实存在的新模型,只是 LMArena 这边的票还不够,位置很低。
辨析
两个条目都做过归一化核对:转小写、剥掉档位后缀再查一遍,历史快照里都没有对应记录,不是改名造成的重复登记。上个月那批因为标识从 slug 改展示名而冒出来的假新条目,这一期没有复发。
4. 分项榜
4.1 编码与网页生成
| 类别 | 前三 | Elo | 投票数 |
|---|---|---|---|
| 编码 | Gemini 4 Carbon (High) | 1,563.4 | 1,072 |
| 编码 | Claude Opus 5.5 (High) | 1,542.2 | 3,339 |
| 编码 | Gemini 4 Argon (High) | 1,540.0 | 4,614 |
| 网页生成 | Claude Opus 5.5 (Max) | 1,817.7 | 4,009 |
| 网页生成 | Claude Sonnet 5.5 (xHigh) | 1,774.3 | 5,493 |
| 网页生成 | Gemini 4 Carbon (High) | 1,768.0 | 2,128 |
编码榜 Carbon 还是第一,1,563.4 分,领先 Opus 5.5 21.2 分,比上期的 22.3 分收窄了一点。第 4、5 名是 Claude Opus 4.6(1,533.9,24,562 票)和 MiMo-V2.6-Pro(1,533.1,1,091 票),两者换了个位置,只差 0.8 分。
网页生成榜这期动得比较明显:Claude Opus 5.5 (Max) 涨 7.9 分到 1,817.7,是分项里最大的单点涨幅;Claude Sonnet 5.5 (xHigh) 涨 4.5 分到 1,774.3,升到第二;GPT-6 Astra (Max) 跌 6.5 分,从 #2 掉到 #4。Carbon 以 1,768.0 排第三。
再看三个子榜:webdev-html 第一还是 GPT-6.1 Sol (Max) 1,792.8(899 票),Carbon 第三(1,771.0,218 票);webdev-react 第一是 Opus 5.5 (Max) 1,868.0;image_to_webdev 第一同样是 Opus 5.5 (Max),1,750.1。
网页生成的分比总榜高近 280 分,这是另一套独立拟合的体系,不能和总榜横向比。
4.2 中文与数学
| 类别 | 前三 | Elo | 投票数 |
|---|---|---|---|
| 中文 | Gemini 4 Carbon (High) | 1,614.1 | 428 |
| 中文 | Gemini 4 Argon (High) | 1,606.0 | 1,613 |
| 中文 | Claude Fable 5.1 (Max) | 1,580.4 | 1,600 |
| 数学 | Gemini 4 Argon (High) | 1,538.3 | 1,046 |
| 数学 | Claude Opus 5 (High) | 1,532.2 | 3,494 |
| 数学 | Claude Fable 5.1 (Max) | 1,530.8 | 975 |
中文榜前两名没换,但差距收窄了:Carbon 领先 Argon 8.1 分,上期是 16.0 分。第三名换成 Claude Fable 5.1 (Max),1,580.4。
数学榜第一还是 Argon(1,538.3,+3.3,1,046 票)。这一期有个变化要单独说:Carbon 从数学榜上消失了。10 月 28 日的快照里它还是第 2(1,536.2,207 票),11 月 6 日之后的数学快照就没有它了,榜单条目数也从 405 降到 404。票数不够的条目会被移出分项榜——这比"它的数学变差了"更接近事实。
数学第 3 到第 5 名(1,530.8、1,530.8、1,525.6)挤在 5.2 分里,基本并列。
这两个榜的票数都薄:中文第一 428 票,数学第一 1,046 票。没有分数的类别之间更不能横向比较。
4.3 视觉与文生图
视觉榜这期终于更新了,上一版停在 10 月 19 日。前五全是 Claude 系:Claude Fable 5 (High) 1,325.6(15,536 票)、Claude Opus 5.5 (High) 1,323.8(4,789 票)、Claude Fable 5.1 (Max) 1,321.6(6,296 票)、Claude Opus 4.7 1,318.7(23,777 票)、Claude Opus 5 (High) 1,317.5(19,345 票)。Opus 5.5 涨 3.0 分,Opus 5 (High) 跌 2.1 分,两者换了位。
文生图榜也翻新到 11 月 9 日,前五被 OpenAI 的图像模型包了:GPT-Image-2.5 Sunburst 1,428.8(57,928 票)、GPT-Image-2.6 Sunburst (Medium) 1,406.1(2,718 票)、GPT-Image-2.5 Flare 1,400.2(57,020 票)、GPT-Image-2.6 Flare (Medium) 1,382.8(2,551 票)、GPT-Image-2 (Medium) 1,381.7(106,021 票)。
图像编辑榜同样更新:Sunburst 1,519.8(120,359 票)、Flare 1,484.5(117,429 票)、GPT-Image-2.6 Sunburst (Medium) 1,476.7(3,520 票)、MAI-Image-2.7-Preview 1,468.3(20,315 票)、GPT-Image-2 (Medium) 1,460.9(355,469 票)。
两条 2.6 条目是这一期新进的,和 OpenAI 11 月 4 日发布的 Images 2.6 对得上:文生图榜第 2 和第 4,图像编辑榜第 3。上一版这两份榜停在 10 月 26 日、27 日,正好错过了新版本。
4.4 写作与指令遵循
| 类别 | 前三 | Elo | 投票数 |
|---|---|---|---|
| 创意写作 | Gemini 4 Argon (High) | 1,534.7 | 4,738 |
| 创意写作 | Claude Opus 5.5 (High) | 1,532.2 | 3,680 |
| 创意写作 | Gemini 4 Carbon (High) | 1,532.1 | 1,005 |
| 指令遵循 | Gemini 4 Carbon (High) | 1,539.6 | 1,419 |
| 指令遵循 | Gemini 4 Argon (High) | 1,537.2 | 7,180 |
| 指令遵循 | Claude Opus 5.5 (High) | 1,535.7 | 5,280 |
创意写作第一还是 Argon(1,534.7,-1.1)。Opus 5.5 涨 1.1 分到 1,532.2,刚好压过 Carbon 的 1,532.1——差 0.1 分,而 Carbon 的票只有 1,005 张,不到 Opus 5.5 的三分之一。
指令遵循前三名只差 3.9 分:Carbon 1,539.6 第一,Argon 涨 1.8 分追到第二(1,537.2),Opus 5.5 1,535.7 第三。
把几项通用类目连起来看:Carbon 拿到编码、中文、指令遵循、多轮对话、长查询、难题六项第一,创意写作第三,数学掉出榜。它在"按指令做事"上领先得清楚,在"写得好看""算得准"上不是最强的那个。
5. 开源侧热度
5.1 模型
| 模型 | 趋势分 | 喜欢 | 30 天下载 | 类型 | 创建 |
|---|---|---|---|---|---|
| speridlabs/idol | 907 | 1,778 | 26,470 | 图生 3D | 10-28 |
| xtools-at/DeepSeek-V4-Pro-Qwen3.5-9B-UNCENSORED-heretic | 893 | 1,137 | 14,378 | 文本生成 | 10-30 |
| moonshotai/Kimi-K3.1-Pro | 605 | 1,836 | 30,721 | 图文理解 | 11-02 |
| ricursiveAI/Ripple-65B-Preview | 452 | 470 | 6,480 | — | 11-04 |
| Lightricks/LTX-2.5 | 394 | 11,324 | 2,791,606 | 图生视频 | 07-23 |
| NousResearch/Arete-27B | 368 | 383 | 3,431 | 文本生成 | 11-06 |
| DavidAU/Qwen3.8-27B-…-NEO-CODER-MAX-MTP-GGUF | 353 | 2,816 | 1,459,029 | 图文理解 | 09-01 |
| ccore/Qwen3.5-4B-3D-Coder | 347 | 967 | 319,405 | — | 10-25 |
| Qwen/Qwen3.8-27B | 326 | 19,540 | 7,443,748 | 图文理解 | 08-05 |
| webAI-Official/TwIL-8B | 265 | 272 | 43,175 | 文本生成 | 10-14 |
趋势榜第一还是 speridlabs/idol(907 分),比上期的 442 分翻了一倍。这个仓库 10 月 28 日才建,做的是图生 3D,30 天下载 26,470——趋势分和下载量一起涨,说明不是光有人围观。
第二是社区微调:xtools-at 把 DeepSeek-V4-Pro 蒸馏到 Qwen3.5-9B 上,命名里堆着 UNCENSORED、heretic 这类词,893 分,1,137 个喜欢。
第三值得和前面的榜单对上:moonshotai/Kimi-K3.1-Pro 605 分、1,836 个喜欢、30,721 次下载,仓库 11 月 2 日建。一周后它出现在 LMArena 第 44 名——发权重、攒下载、进榜,这条线终于是完整的。
新建仓库里还有两个:ricursiveAI/Ripple-65B-Preview 11 月 4 日建,趋势 452,同一天在 OpenRouter 上架($0.20/$0.60);NousResearch/Arete-27B 11 月 6 日建,368 分。
下载量那一列要分开读。LTX-2.5 的 279 万下载和 11,324 个喜欢是 7 月以来的累计,Qwen3.8-27B 的 744 万同理,这些数字说明的是长期影响力;趋势分才是近期相对热度,两列不能互相替代。
5.2 数据集与 Space
数据集第一换成了 Angais/pixel-art-atlas-1.4m(趋势 290,30,689 下载,11 月 6 日建),一个 140 万张的像素画素材集。上期第一的 nvidia/simready-assets 掉到第三(145,146.7 万下载,1,524 个喜欢)。第二是 Vyber07/cyber-security(184,880 个喜欢)。
第四是刚建的 3D 资产集 codepawl/abo-glb(103,4.0 万下载,11 月 4 日建),第五是 open-index/hacker-news(100,47.5 万下载),第六是另一个刚建的 tencent/TailorRig(70,5,101 下载,11 月 4 日建)。3D / 仿真这条线在上期占了数据集前五的三席,这一期前五里还剩两席。
Space 榜前两名是 Hugging Face 自己的 moe-blogpost(515,529 个喜欢)和 thea2026/image-to-video(408,678 个喜欢,11 月 6 日建)。第三是 joelniklaus/harness-leaderboard(254)——一个跑评测的界面。剩下两席是图生视频工具 wan777(148)和 speridlabs/idol(118),后者和趋势榜第一同名。
6. 价格与上下文
6.1 本周新增
OpenRouter 全站 469 个条目,剔掉 8 个用负数占位价的路由模型后是 461 个。本期窗口内新增 16 条,对应 12 个模型加 4 个变体(2 个 :batch、2 个 :free);上期只有 3 条。
| 模型 | 上线 | 上下文 | 输入价 | 输出价 |
|---|---|---|---|---|
| tencent/hy4 | 11-04 | 1.05M | $0.42 | $1.25 |
| ricursiveai/ripple-65b-preview | 11-04 | 1.05M | $0.20 | $0.60 |
| google/gemini-omni-1.1-flash | 11-04 | 131K | $1.50 | $9.00 |
| kt/midm-k-3.0-pro | 11-05 | 262K | $0.20 | $0.80 |
| google/gemini-omni-1.2-flash | 11-05 | 131K | $1.50 | $9.00 |
| liquid/lfm-3-1.7b | 11-06 | 262K | $0.08 | $0.20 |
| liquid/lfm-3-1.7b:free | 11-06 | 262K | 免费 | 免费 |
| meta/muse-ember | 11-09 | 1.05M | $0.10 | $0.50 |
| anthropic/claude-fable-5.2 | 11-09 | 1.00M | $8.00 | $40.00 |
| anthropic/claude-fable-5.2:batch | 11-09 | 1.00M | $4.00 | $20.00 |
| thinkingmachines/inkling-2-small:free | 11-09 | 1.05M | 免费 | 免费 |
| nex-agi/nex-n2.6 | 11-10 | 262K | $0.12 | $0.40 |
| google/gemini-4-carbon | 11-10 | 1.05M | $2.00 | $10.00 |
| google/gemini-4-carbon:batch | 11-10 | 1.05M | $1.00 | $5.00 |
| baidu/ernie-light-dt-1.0-intl | 11-10 | 1.02M | $1.13 | $3.94 |
| baidu/ernie-5.5-flash-preview | 11-10 | 1.02M | $0.28 | $1.13 |
价格单位是每百万 token。
最贵的一条是 anthropic/claude-fable-5.2($8/$40),batch 变体砍半;最便宜的是 liquid/lfm-3-1.7b($0.08/$0.20)和 meta/muse-ember($0.10/$0.50)。
这一期最值得记的是 google/gemini-4-carbon 上架:11 月 10 日,$2/$10,1.05M 上下文。上一期它在 OpenRouter 上还查不到报价,当时只能从榜单票数推断它在测试;现在它是公开报价的模型了,而且价格落在中档,不是最贵的那一档。
两条免费条目都挂着 1.05M 上下文:liquid/lfm-3-1.7b:free 和 thinkingmachines/inkling-2-small:free。
6.2 价格分层
461 个报价条目按上下文档分四层,输出价中位数如下:
| 上下文档 | 模型数 | 输出价中位数 |
|---|---|---|
| 小于 128K | 67 | $0.90 |
| 128K–1M | 263 | $2.00 |
| 1M–2M | 131 | $3.20 |
| 2M 以上 | 0 | — |
混在一起算,输出价中位数是 $2.00,最低 $0.00(免费条目),最高 $180(openai/gpt-5.5-pro),一头一尾没法比。付费 446 条,免费 15 条;1M 以上上下文的 131 条,占 28.4%。输出价不高于 $0.50 的有 120 条,不低于 $50 的有 16 条。
1M 那一层的中位数 $3.20,是 128K 以下那层($0.90)的 3.6 倍,长上下文仍然要加钱。2M 以上这一层这次一条都没有,样本消失,不做解读。
7. 本周发布
OpenAI 这一周发了两样东西。11 月 5 日的 GPT-6 Cyber 主打"对齐过的网络安全 agent",官方定位是防御侧自动化的前沿。11 月 4 日是 Images 2.6——这一条在榜单里能直接看到痕迹:11 月 9 日的文生图榜新进两条 2.6 条目(第 2、第 4),图像编辑榜第 3 也是 2.6。GPT-6 Cyber 在 11 月 9 日的 LMArena 快照里还没有条目,OpenRouter 上也查不到报价,收录比发布慢了一步。同一周还有一条资本动作:11 月 4 日宣布收购 Pierre Computer Company。
Google 11 月 5 日发 Gemini Omni 1.2 Flash,官方说法是更长的视频片段、更快更便宜。文生视频榜 11 月 9 日更新,Omni 1.2 Flash 以 1,540.1 排第一,Omni 1.1 Flash 第二(1,513.0)——上一版停在 9 月 22 日,这次等于把两代 Omni 一次性补了进来。11 月 10 日还有三个动作:Android 上的 Gemini Intelligence 功能、Adobe 工具接入 Google 应用、Google Cloud 的 Gemini for healthcare。
Anthropic 11 月 9 日把 claude-fable-5.2 上架 OpenRouter(1M 上下文,$8/$40)。它在能力指数榜上已经拿到 64.56 排第一,但 LMArena 11 月 9 日的快照里没有它——两套口径的收录速度差,这期最明显。
Meta 11 月 9 日上架 muse-ember($0.10/$0.50,1.05M),能力指数榜第 13(36.02),LMArena 同样还没条目。
中国厂商这边:腾讯 hy4 11 月 4 日上架 OpenRouter($0.42/$1.25,1.05M),能力指数榜第 15(34.56);百度 11 月 10 日上架 ernie-5.5-flash-preview($0.28/$1.13)和 ernie-light-dt-1.0-intl($1.13/$3.94)。Liquid AI 的 LFM3-1.7B 11 月 6 日上架,$0.08/$0.20,是这期最便宜的新条目。
Hugging Face 博客这周偏工程:11 月 10 日的 HF Hub 支持 Google Cloud 账号付费、Decision Models(决策模型);11 月 6 日的 ToyBlocks 给机器人学习搭了一个受控环境,Open ASR Leaderboard 新增埃及和尼日利亚英语;11 月 5 日的 Phonon TTS 主打端上语音合成。
8. 本期观察
第一,榜单进入日更,周榜要重新定义"周"。 窗口内三次快照,相邻两次只隔一天;这一天里前 80 名最大位移 3 位,48 个模型名次没动。这不是榜单失灵,而是发布节奏变快后,单日抖动被当成了"周变化"。读名次变化至少要跨一周,看单日零点几分的涨跌没有意义。
第二,收录速度成了两套体系的分水岭。 Claude Fable 5.2 11 月 9 日上架,能力指数榜当天就有 64.56 分排第一,LMArena 的快照里没有它;Kimi K3.1 Pro 10 月 23 日上线,直到 11 月 9 日才进榜。想在新模型发布当周回答"它强不强",只能用固定评测集;社区盲投榜需要一两周攒票。
第三,榜首的领先还在误差里。 Carbon 1,538.3 分,区间 ±9.54 分,领先 Argon 8.1 分。它的票数几乎不涨:一天多 1 张,比 12 天前的 4,403 还少;同期 Argon 一天 +937 张。票继续往 Argon 那边走,8.1 分的领先迟早会被摊平。
第四,价格不解释位置,但头部还有定价权。 本期新增 12 个模型,最贵的 Fable 5.2($8/$40)在能力指数榜排第一,最便宜的 Muse Ember($0.10/$0.50)排第 13,1.7B 的 LFM3 不在前 30。中档的 Gemini 4 Carbon($2/$10)在总榜第一、能力指数第二——能力和价格之间没有一条线,只有梯队。
9. 数据说明
能力排名来自 LMArena 的社区盲测:用户同时看到两个匿名模型的回答,投票选出更好的那个,再用大量对战结果拟合成 Elo 分数。分数本身没有绝对含义,只有相对意义——1,538.3 分不代表"1,538.3 分的水平",只代表在这批模型里排第一。
读这张榜要注意三件事。
一是看票数。 票少的新模型波动大。这期榜首只有 4,282 票,区间 ±9.54 分;前 20 名的区间半宽中位数是 4.63 分。表里 ±0.5 分的"周变化"基本等于没动,票数上万的模型,1 分的变动才值得留意。
二是看类别。 总榜、编码、中文、数学各自独立拟合,分数不能跨类别比较。网页生成的第一名 1,817.7 分不是"比总榜第一名强 280 分",而是另一套评分体系里的另一个位置。中文、数学这类子榜票数只有几百到一千,结论要打折扣;票数太少的条目还会被移出分榜。
三是看偏向。 盲测用户以英文使用者为主,题目偏通用对话和编码,擅长这两类的模型天然占优;多模态、长上下文、工具调用在这张榜上体现有限。视觉、文生图、图像编辑、文生视频是独立的数据集,更新节奏也不一样——这期它们分别在 11 月 9 日翻新,文生视频上一版还停在 9 月 22 日。
时间窗是 2026 年 11 月 4 日到 11 月 10 日。窗口内总榜发了三次快照(11 月 6 日、8 日、9 日),表里的"周变化"取相邻两次(8 日 → 9 日);第 3 节另给了从上一期快照(10 月 28 日)算起的累计变化,那是同一 category、间隔 12 天的两个快照,只作跨周参考1。榜单在 10 月中旬把模型标识从内部 slug 改成了展示名,切换期间同一批历史模型曾被当成新条目重新登记;这期归一化之后,419 个上期条目全部对上,只多了 2 个真新条目2。
开源侧的趋势分是近期相对热度,下载量是滚动 30 天口径,两者不能互相替代。第 1 节的能力指数是另一套评分体系,和 Elo 只能各自纵向比较,不能换算——它也没有历史序列,做不了周环比。
版权声明:如无特殊说明,文章均为本站原创,转载请注明出处
本文链接:https://tendcode.com/subject/article/ai-weekly-20261110/
许可协议:署名-非商业性使用 4.0 国际许可协议